

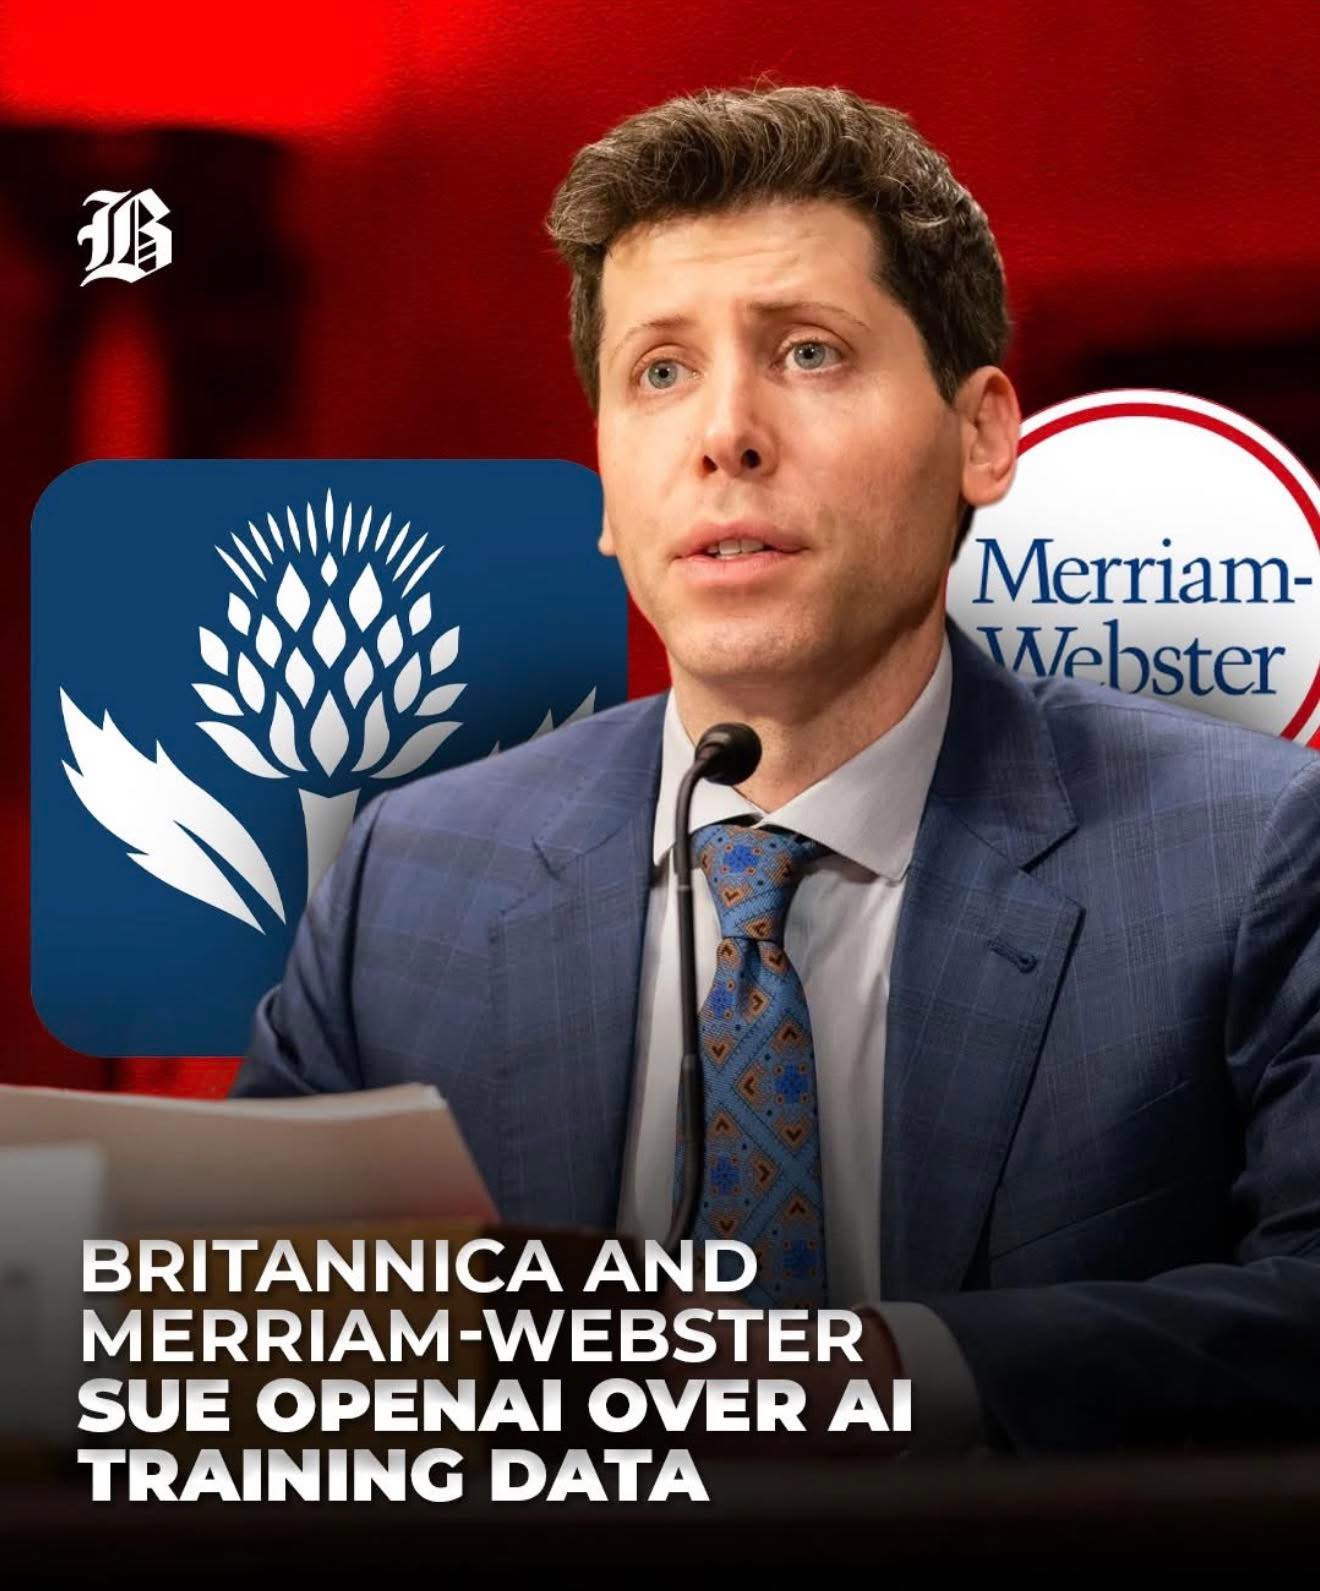
Britannica и Merriam-Webster заведоха дело срещу OpenAI.
Britannica и Merriam-Webster заведоха дело срещу OpenAI във федералния съд в Манхатън, като този казус не се отличава от останалите, които вече са факт в САЩ. Така коментира последното заведено по темата дело в Съединените американски щати, специалистът по AI технилогии адвокат Атанас Костов.
Твърдението на ищците е ясно и категорично: OpenAI е използвала близо 100 000 енциклопедични и речникови материала, за да обучи ChatGPT — без разрешение, без лиценз и без каквото и да е заплащане. Става въпрос за съдържание, изграждано с десетилетия внимателна редакторска работа и подбор. Българското авторско право нарича това “съставни произведения”.
Проблемът с „изместването“: Britannica не се ограничава до обвинение в копиране. Според тях ChatGPT предоставя отговори, които са почти идентични с оригиналите и така елиминира нуждата потребителите да посещават техните платформи, пряко засягайки приходите им от реклама и абонаменти на Britanica.
Рискът за бранда. Тъй като ChatGPT генерира неточна информация и я свързва с името на Britannica, това подкопава репутация, изграждана над 250 години. Тук вече не става дума само за авторско право, а и за потенциално нарушение на търговска марка — сравнително нов аспект в делата, свързани с изкуствен интелект.
Какъв е юридическият фон по казуса? Преди завеждане на съдебния иск са правени извънсъдебни опити за разговори, с цел лицензиране, но без успех. От своя страна OpenAI разчита на аргумента за „fair use“ или на български казано “честна употреба” в хипотезата на свободно използване. Въпреки това съдия Алсъп вече даде сигнал в делото срещу Anthropic, което приключило с колективно споразумение за 1,5 милиарда долара, че подобен тип аргументация на защитата има граници, особено когато не е платено за използваното съдържание.
Очаква се делото да бъде присъединено към по-голямо производство в Южния окръг на Ню Йорк, където вече текат подобни искове от страна на NYT и други издатели.
Крайно решение едва ли ще бъде постановено преди началото на 2027г. За справка на по-любопитните, номерът на делото е 1:20226cv02097.
Основният въпрос остава: къде минава границата между данни за обучение на машини и интелектуална собственост? Към момента в САЩ има 91 дела за авторски права срещу AI компании, което ясно показва, че натискът за изясняване на тази граница нараства.
"Личното ми мнение е, че ОpenAI — както и всяка друга технологична компания, действаща по този варварски начин, насочен към извършване на авторскоправни нарушения, трябва да понесе сериозни юридически последствия. Не е приемливо да се използва авторско съдържание, създавано с години усилия и инвестиции на големи редакрторски и авторски екипи и то да се предлага безплатно, сякаш този интелектуален труд няма стойност. Това не е “иновация”, а форма на незаконно присвояване" - заяви по темата адвокат Атанас Костов.
Още по-притеснително е, че подобно съдържание често губи контекст, съдържа грешки и се представя по начин, който отклонява аудиторията от оригиналните източници — именно тези, от които зависи дадена обективна информация, мотивира виждането си по казуса адв.Костов.
Доколкото познавам американското правосъдие санкцията ще бъде достатъчно строга(според мен стотици милиони), за да изпрати ясно послание: съдържанието има цена, а използването му без разрешение не е устойчив модел — това е авторскоправно нарушение.